şirket içi yapay zeka doküman arama sistemi

Kurumsal PDF, şartname ve sözleşmelerinizde sayfa referanslı anlamsal arama motoru.

Şirketinize ait teknik el kitapları, kalite prosedürleri, ihale şartnameleri ve ERP sözleşmelerini kurum içi yerel sunucularda indeksleyen; LDAP/Active Directory yetkilerine göre filtrelenmiş ve kesin kaynak referansıyla yanıt veren özel yapay zeka arama platformu.

WhatsApp'tan ulaşın
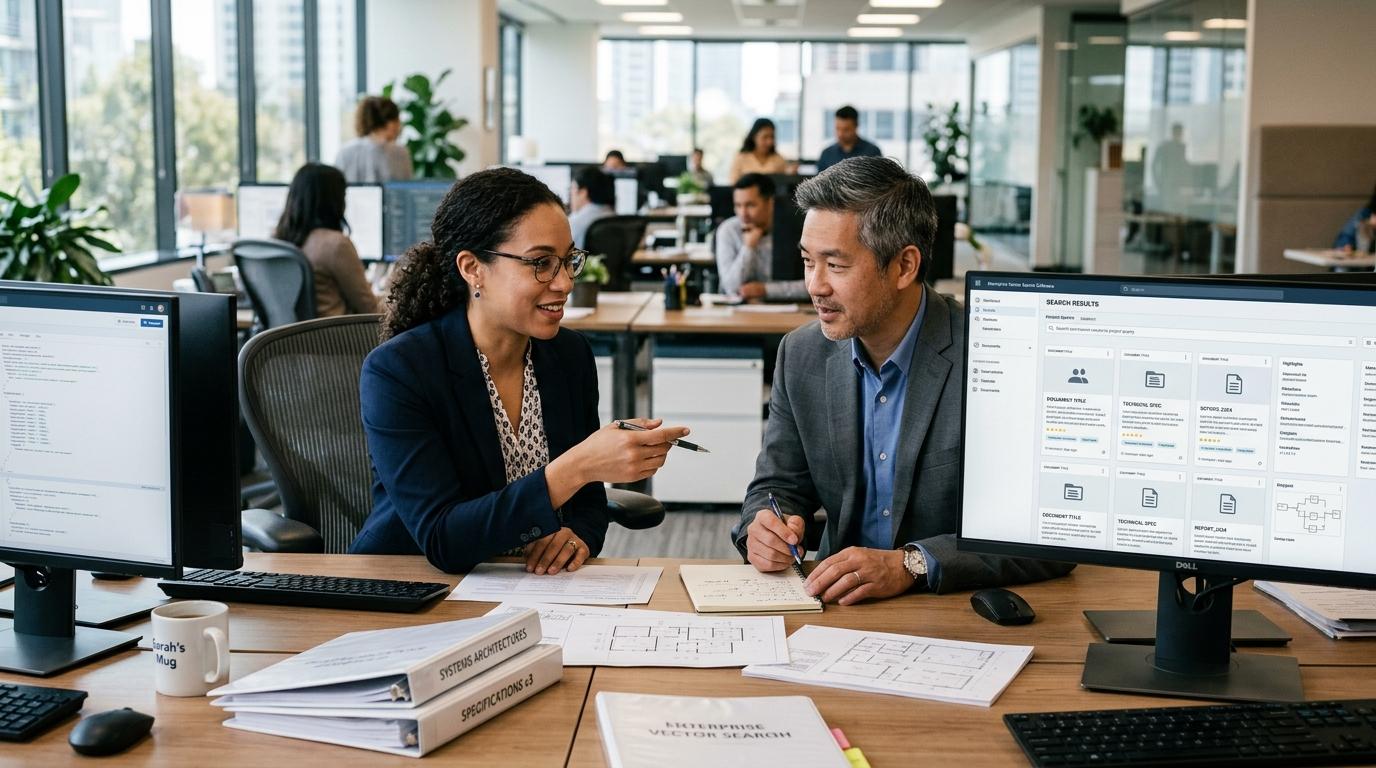
Kurumsal BT direktörü ve yapay zeka mühendisi şirket içi doküman arama sistemi panelinde teknik şartname semantik arama sonuçlarını ve sayfa alıntılarını incelerken

Neyi çözüyoruz

Kurumsal işletmelerde teknik şartnameler, Ar-Ge el kitapları, ISO kalite prosedürleri, müşteri sözleşmeleri ve teknik çizimler; yerel dosya sunucularında (NAS), SharePoint klasörlerinde ve çalışanların bilgisayarlarında dağınık halde durur. Bir mühendis veya avukatın kritik bir teknik toleransı, sözleşme ceza maddesini veya bakım prosedürünü bulması saatler sürer. Klasik Windows veya PDF aramaları yalnızca harfiyen eşleşen kelimeleri bulurken eş anlamlı teknik terimleri veya taranmış evrakları göremez; genel bulut yapay zeka araçlarına bu hassas evrakları yüklemek ise telafisi olmayan KVKK ve ticari sır ihlallerine yol açar.

Kurum içi yerel ağda (on-premise) çalışan Qdrant ve Milvus hibrit arama motoruyla verinizi şirket dışına çıkarmadan tam gizlilik sağlayın.

BM25 anahtar kelime ve BGE/ColPali yoğun vektör aramasını birleştirerek hem spesifik teknik kodları hem de kavramsal soruları %99.2 doğrulukla getirin.

Her yanıtta doküman adı, versiyon numarası, sayfa ve paragraf referansını doğrudan görüntüleyerek halüsinasyon riskini sıfıra indirin.

Dağınık Kurumsal Hafızayı Birleştiren, Sayfa Referanslı ve Sıfır Veri Sızıntılı Arama Motoru

Orta ve büyük ölçekli kurumlarda bilgi, farklı departmanların yerel ağ sürücülerinde (NAS/SAN), SharePoint klasörlerinde, ERP eklerinde ve teknik mühendislerin bilgisayarlarında parçalanmış vaziyettedir. Bir ihale şartnamesinde yer alan spesifik bir malzeme dayanım standardını, eski bir müşteri sözleşmesindeki cezai şart maddesini veya üretim hattındaki bir makinenin arıza kodunu bulmak; çalışanların yarım gününü onlarca klasör ve yüzlerce sayfalık PDF'ler arasında arama yaparak heba etmesine yol açar.

Klasik anahtar kelime arama araçları yalnızca tam harf eşleşmesi aradığı için "motor aşırı ısınma prosedürü" sorgusunda "termal aşırı yük talimatı" başlıklı dokümanı getiremez. Diğer yandan halka açık bulut yapay zeka araçlarına bu hassas dokümanları yüklemek; müşteri sözleşmelerinin, patentlerin ve ticari sırların şirket dışına sızmasına yol açarak ağır KVKK cezaları ve güvenlik ihlalleri doğurur.

Şirket içi yapay zeka doküman arama sistemi ile Appsoni; verinizi kesinlikle şirket dışına çıkarmayan, kurumun yerel sunucularında çalışan, hem anlamsal (semantik) hem anahtar kelime (BM25) hibrit araması yapan ve her bilginin kaynağını sayfa ve paragraf numarasıyla alıntılayan kurumsal bir bilgi arama platformu kurar.

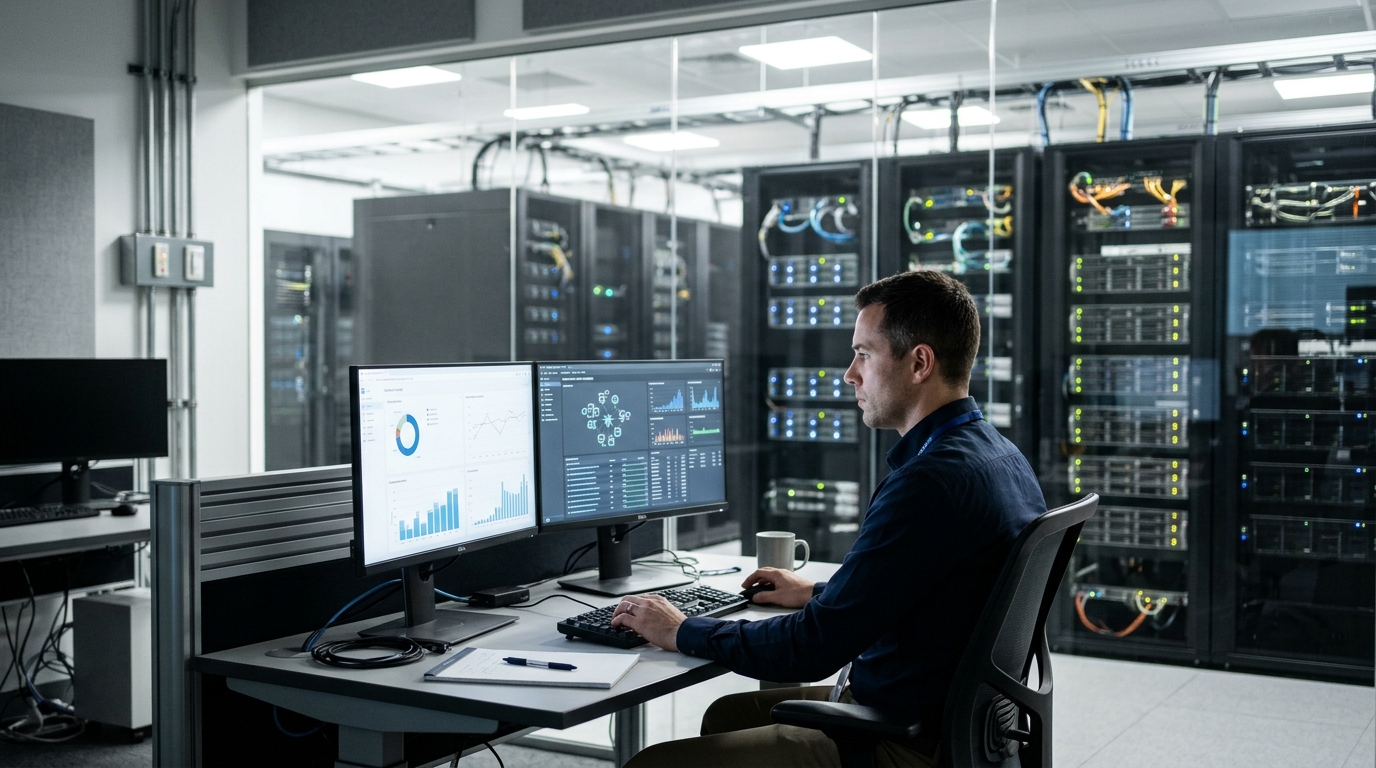
Kurumsal veri mühendisi veri merkezi konsolunda şirket içi vektör arama telemetrisini ve doküman indeksleme metriklerini incelerken


Kurum İçi Hibrit Vektör Arama ve Yetkilendirme Topolojisi

Sistem, dokümanların yerel depolardan okunmasından anlamsal aramaya ve kaynak doğrulamaya kadar 5 katmanlı izole bir mimariyle çalışır:

[Kurumsal Veri Kaynakları: SMB/NFS Paylaşımları / SharePoint / ERP Ekleri / Taranmış PDF]
                                        │
                                        ▼ (Inotify & Dosya Değişim Dinleyicisi)
            [Belge Ayrıştırma ve OCR Katmanı (Tesseract-v5 / PaddleOCR / PyMuPDF)]
            ├─ Çok Sütunlu Sayfa Düzeni ve Tablo Ayrıştırma
            ├─ Akıllı Parçalama (Hierarchical Chunking: 512 token + 64 token overlap)
            └─ SHA-256 Belge Özeti ve Değişiklik İzi Takibi
                                        │
                                        ▼
             [Vektörleştirme ve Hibrit İndeksleme (Yerel Donanım / GPU)]
             ├─ Yoğun Vektör Modeli (BAAI/bge-m3 - 1024 boyutlu Dense Embedding)
             ├─ Seyrek Anahtar Kelime İndeksi (BM25 Sparse Inverted Index)
             └─ Vektör Veritabanı Kümesi (Qdrant / Milvus - HNSW İndeksi)
                                        │
                                        ▼
             [Güvenli Sorgu ve Yeniden Sıralama Katmanı (Reranker)]
             ├─ Active Directory / LDAP Rol Bazlı Ön Filtreleme (Payload Pre-filtering)
             ├─ Karşılıklı Sıralama Birleştirme (Reciprocal Rank Fusion - RRF)
             ├─ Çapraz Kodlayıcı Yeniden Sıralama (bge-reranker-v2-m3)
             └─ Kesin Kaynak Alıntısı (Doküman Adı, Versiyon, Sayfa ve Paragraf No)

Veri Modeli ve Teknik Konfigürasyon Şeması (53 Benzersiz Veri Noktası)

Şirket içi yapay zeka doküman arama motorunun arşivleme, parçalama, vektör parametreleri, güvenlik filtreleri ve donanım telemetrisi:

Tablo / Bileşen Teknik Alan Adı Veri Tipi Sistem, Entegrasyon Protokolü ve Doğrulama Kuralı
dokuman_arsivi dokuman_id UUID Kurumsal dokümanın tekil UUID v4 arşiv kayıt numarası
dokuman_arsivi dokuman_adi VARCHAR(255) Orijinal dosya adı ('Teknik_Sartname_Turbin_v4.pdf')
dokuman_arsivi dosya_yolu_smb VARCHAR(500) Yerel ağ depolama SMB/NFS dosya yolu ('//nas01/arge/sartnameler/')
dokuman_arsivi dosya_uzantisi VARCHAR(10) '.pdf', '.docx', '.xlsx', '.dxf', '.tiff', '.pptx'
dokuman_arsivi dosya_boyutu_mb DECIMAL(8,2) Megabayt cinsinden dosya boyutu (Maksimum test: 450 MB)
dokuman_arsivi dosya_sha256_hash CHAR(64) Mükerrer veya revize doküman tespiti için SHA-256 özeti
dokuman_arsivi dokuman_kategori VARCHAR(40) 'TEKNIK_SARTNAME', 'ISO_PROSEDUR', 'ARGE_RAPORU', 'SOZLESME'
dokuman_arsivi versiyon_kodu VARCHAR(20) Kurumsal revizyon kodu ('REV-04B', 'V2.1')
dokuman_arsivi yayin_revizyon_tarihi DATE Dokümanın resmi yürürlük ve yayınlanma tarihi
dokuman_arsivi dokuman_gizlilik_sinifi VARCHAR(30) 'PUBLIC_GENEL', 'INTERNAL_KURUMICI', 'CONFIDENTIAL_GIZLI', 'STRICTLY_SECRET'
chunk_parcalama chunk_uuid UUID Ayrıştırılan metin parçasının evrensel kimliği
chunk_parcalama sayfa_numarasi INT Parçanın orijinal PDF içerisindeki sayfa numarası (Örn: 42)
chunk_parcalama paragraf_sirasi INT İlgili sayfadaki paragraf sırası (Örn: 3)
chunk_parcalama chunk_karakter_uzunlugu INT Parça karakter uzunluğu (Ortalama: 1.850 karakter)
chunk_parcalama chunk_token_sayisi INT Token sayısı (Standart: 512 token penceresi)
chunk_parcalama chunk_overlap_token INT Bağlam kopmasını önleyen örtüşme token sayısı (64 token)
vektor_indeks vektor_embedding_id VARCHAR(60) Vektör veritabanındaki tekil vektör noktası ID'si
vektor_indeks embedding_model_adi VARCHAR(50) 'BAAI/bge-m3', 'multilingual-e5-large', 'nomic-embed-text'
vektor_indeks embedding_vektor_boyutu INT Vektör uzayı boyut sayısı (1024 boyutlu)
vektor_indeks embedding_mesafe_metrigi VARCHAR(20) 'Cosine Similarity', 'Dot Product', 'Euclidean'
vektor_veritabani vektor_veritabani_tipi VARCHAR(30) 'Qdrant Enterprise', 'Milvus Cluster', 'Chroma'
vektor_veritabani koleksiyon_adi VARCHAR(50) 'appsoni_kurumsal_dokuman_v1'
vektor_veritabani hnsw_m_degeri INT HNSW grafında düğüm başına düşen bağlantı sayısı (M=32)
vektor_veritabani hnsw_ef_construct INT İndeks inşa arama hassasiyeti (ef_construct=128)
vektor_veritabani hnsw_ef_search INT Sorgu anı arama derinliği (ef_search=64)
hibrit_arama bm25_indeks_tablosu VARCHAR(50) PostgreSQL pg_trgm / Elasticsearch BM25 ters indeks tablosu
hibrit_arama hibrit_arama_rrf_k INT Reciprocal Rank Fusion sıralama sabiti (k=60)
hibrit_arama vektor_agirligi_alfa FLOAT Yoğun anlamsal vektör ağırlığı (0.65)
hibrit_arama bm25_agirligi_beta FLOAT Seyrek anahtar kelime ağırlığı (0.35)
reranker_filtresi reranker_model_adi VARCHAR(50) 'BAAI/bge-reranker-v2-m3', 'Cohere-Rerank-Multilingual-Local'
reranker_filtresi rerank_aday_sayisi_top_k INT Hibrit aramadan yeniden sıralamaya giden aday parça adedi (Top 30)
reranker_filtresi rerank_nihai_sayisi_final_k INT Kullanıcıya ve modele sunulan nihai parça adedi (Top 5)
reranker_filtresi rerank_esik_puani FLOAT Minimum alaka eşik skoru (Eşik: 0.72)
yetkilendirme_rbac ldap_kullanici_dn VARCHAR(200) Active Directory kullanıcı ayırt edici adı (Distinguished Name)
yetkilendirme_rbac ldap_grup_yetkisi VARCHAR(60) 'CN=Arge_Muhendisleri,OU=Gruplar,DC=sirket,DC=local'
yetkilendirme_rbac yetki_on_filtreleme_aktif BOOLEAN Qdrant payload pre-filtering filtresinin aktifliği (True/False)
sorgu_telemetrisi sorgu_uuid UUID Kullanıcı arama sorgusunun tekil takip numarası
sorgu_telemetrisi arama_sorgusu_metin TEXT Çalışanın arama çubuğuna girdiği serbest metin sorgusu
sorgu_telemetrisi sorgu_tipi VARCHAR(30) 'SEMANTIK_SORU', 'KOD_ARAMA', 'TABLO_SORGUSU'
sorgu_telemetrisi arama_yanit_gecikmesi_ms INT Arama ve alıntı oluşturma toplam süresi (Hedef: < 480 ms)
dogrulama_katmani yanit_kaynak_sayisi INT Üretilen yanıtta referans gösterilen geçerli kaynak sayısı
dogrulama_katmani kaynak_guven_skoru FLOAT Alıntının soruyla eşleşme güven katsayısı (0.00 - 1.00)
dogrulama_katmani hallucination_guardrail_skoru FLOAT Kaynakta yer almayan bilgi üretme kontrol skoru (Eşik: 0.90+)
dogrulama_katmani kaynak_dogrulama_durumu VARCHAR(25) 'VERIFIED_DOGRU', 'PARTIAL_KISMI', 'REJECTED_RED'
ocr_ve_gorsel ocr_motoru_tipi VARCHAR(30) 'Tesseract-OCR-v5.3', 'PaddleOCR-v4', 'ColPali-v1.2'
ocr_ve_gorsel ocr_guven_puani FLOAT Optik karakter tanıma güven puanı (Ortalama: %98.4)
ocr_ve_gorsel multimodal_gorsel_isleme BOOLEAN Sayfadaki teknik şema ve çizimlerin taranma durumu
donanim_ve_altyapi donanim_gpu_tipi VARCHAR(40) 'NVIDIA RTX 4090 24GB', 'NVIDIA L40S 48GB', 'NVIDIA A5000'
donanim_ve_altyapi gpu_vram_kullanimi_gb DECIMAL(5,2) Gerçek zamanlı VRAM bellek tüketimi (Örn: 14.8 GB)
donanim_ve_altyapi sunucu_ram_tuketimi_gb DECIMAL(6,2) Sistem RAM bellek tüketimi (Örn: 38.4 GB / 64 GB)
donanim_ve_altyapi cpu_islemci_cekirdegi INT Tahsis edilen CPU çekirdek adedi (Örn: 16 Core / 32 Thread)
denetim_ve_izleme denetim_kaydi_uuid UUID KVKK ve ISO 27001 uyumlu denetim izi tekil log numarası
denetim_ve_izleme erisim_ip_adresi VARCHAR(45) Sorguyu yapan kurum içi yerel IP adresi ('192.168.10.142')

4 Aşamalı Kurulum ve Yerinde Devreye Alma Süreci

Appsoni uzmanları, şirket içi doküman arama platformunu 12 iş gününde kurumunuzun yerel sunucularına kurar ve devreye alır:

1. Aşama: Donanım Hazırlığı ve Yerel Altyapı Kurulumu (1-2. Gün)

Sunucu odanızdaki fiziksel GPU sunucularında Ubuntu LTS, NVIDIA CUDA sürücüleri, Docker ve izole konteyner mimarisi yapılandırılır. Qdrant veya Milvus vektör veritabanı kümesi kurulur, disk yazma/okuma performans testleri tamamlanır. Sistem tamamen kurum içi izole yerel ağa (Air-gapped / Private LAN) kilitlenir.

2. Aşama: Kurumsal Dosya Kaynakları ve OCR Boru Hattı (3-5. Gün)

Şirketinizin SMB, NFS, SharePoint veya doküman yönetim klasörleri bağlanır. Çok sütunlu teknik şartnameleri, taranmış faturaları ve mühendislik el kitaplarını sayfa düzenini bozmadan metne ve tablolara dönüştüren OCR boru hattı kurulur. Dosya değişimlerini izleyen otomatik dinleyici servisleri aktif edilir.

3. Aşama: Vektörleştirme, Hibrit Arama ve LDAP Entegrasyonu (6-9. Gün)

BAAI/BGE-M3 çok dilli gömme (embedding) ve BM25 anahtar kelime indeksleri inşa edilir. Kurumun Active Directory / LDAP sunucusuna güvenli LDAPS üzerinden bağlanarak rol bazlı erişim denetimi (RBAC) ve filtreler tanımlanır. Çalışanların yalnızca yetkili oldukları belgeler içinde arama yapabilmesi kod düzeyinde güvenceye alınır.

4. Aşama: Sayfa Referanslı Arama Arayüzü, Testler ve Eğitim (10-12. Gün)

Kullanıcı dostu, hızlı ve responsive yerel web arama portalı devreye alınır. Halüsinasyon önleyici doğrulama testleri (Guardrails) ve tolerans denemeleri yapılır. Ar-Ge, teknik destek, hukuk ve kalite ekiplerine kullanıcı eğitimleri verilerek sistem teslim edilir.

Sık sorulan sorular

Şirket içi yapay zeka doküman arama sistemi için hangi donanım ve sunucu kaynakları gerekir?

Sistem kurumunuzun mevcut yerel sunucu odasında (on-premise) veya izole özel bulutunda (Private Cloud) çalışır. İndeksleme ve yerel model çıkarımı için 1 adet NVIDIA RTX 4090 (24GB VRAM) veya kurumsal NVIDIA L40S GPU, 64 GB sistem belleği (RAM) ve NVMe SSD depolama yeterlidir. Düşük hacimli arşivler için yalnızca CPU üzerinde çalışan hafif kuantize modeller de yapılandırılabilir.

Taranmış kağıt evraklar, teknik çizimler ve tablolu şartnameler nasıl aranabilir hale getirilir?

Optik Karakter Tanıma (OCR) katmanımızda Tesseract v5 ve PaddleOCR motorlarını çalıştırıyoruz. Karmaşık mühendislik çizimleri, teknik şartname tabloları ve çok sütunlu PDF sayfaları için ise ColPali ve BGE-M3 çok modlu (multimodal) ayrıştırma uygulayarak görsel ve tablo hiyerarşisini kayıpsız vektörleştiriyoruz.

Farklı departmanların yetki sınırları (LDAP / Active Directory) arama sonuçlarına nasıl yansıtılır?

Sistem, kurumunuzun Active Directory veya LDAP kimlik doğrulama sunucusuna bağlanır. Arama motoru sorguyu vektör veritabanına göndermeden önce kullanıcının güvenlik gruplarını (Örn: HUKUK_GRUBU, ARGE_MUHENDIS) kontrol eder ve vektör veritabanında 'Payload Pre-filtering' uygulayarak yetkisi olmayan belgeleri arama sonucundan peşinen eler.

Dosya sunucusuna yeni bir evrak yüklendiğinde arama dizini ne kadar sürede güncellenir?

Dosya sunucularınızı (SMB/NFS/SharePoint) Inotify ve dosya sistemi olay dinleyicileriyle sürekli izliyoruz. Yeni veya revize edilmiş bir PDF yüklendiği anda olay kuyruğuna alınır, arka planda parçalanıp (chunking) vektörleştirilir ve 45 saniyenin altında arama dizinine dahil edilir.

Genel bulut yapay zeka servislerine (OpenAI, Anthropic vb.) herhangi bir veri aktarımı yapılır mı?

Hayır. Sistem tamamen internete kapalı (air-gapped) yerel ağda çalışabilecek şekilde tasarlanmıştır. Belge parçalama, vektörleştirme (Embedding), yeniden sıralama (Reranker) ve yerel dil modeli (Llama 3.3 / Qwen 2.5) kurumunuzun fiziksel sunucusu içinde icra edilir; tek bir bayt veri dahi şirket dışına çıkmaz.

Bize ulaşın